
Последние новости
17.10.2026, 20:41 Classic Fusion Tributo: триумфальное возвращение к оригинальному дизайну 1980 года
17.10.2026, 19:06 Переосмысление ценности сетей для нового роста в эпоху искусственного интеллекта
16.10.2026, 21:30 В Петербурге на Роспроме представят точки промышленного роста
11.10.2026, 18:14 На рынке Москвы появился новый нетворкинг-клуб
09.10.2026, 18:00 Анна Смоляная, основатель компании Diovis Eco, о том, как изменится экологический инжиниринг в России
09.10.2026, 18:40 УК «САМПА» провела экспертную дискуссию «Бизнес.Диалоги» в ТРЦ «ИЮНЬ» в Череповце
07.10.2026, 17:03 Врач рассказал, что приготовить на ужин за 15 минут, когда нет времени
07.10.2026, 17:10 От совместимости к синергии: Р7 и Группа Астра подписали соглашение на ИТ-Форуме «Цифровые решения»
07.10.2026, 16:25 Логистические операторы зафиксировали рост перевозок зоотоваров
06.10.2026, 17:57 Доклад Habitat for Humanity: трое из четырех человек сокращают расходы на предметы первой необходимости, чтобы позволить себе жилье
Компания iText Group NV анонсировала выпуск iText pdfOCR
Общество
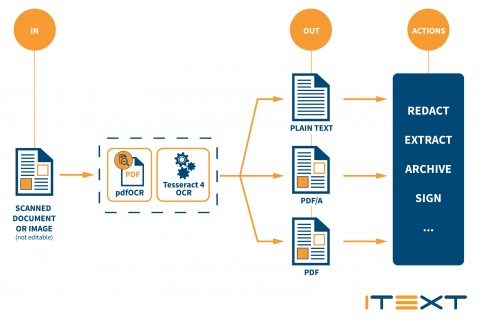
Сегодня компания iText Group NV объявила о выпуске нового дополнения к своему отмеченному наградами программному обеспечению, которое работает на движке оптического распознавания символов Tesseract.
Гент, Бельгия, 23 июня 2020 года. Компания iText Group NV, всемирно признанный идейный лидер и новатор в области разработки решений для работы с PDF-файлами, объявила сегодня о выпуске iText pdfOCR — новейшего дополнения к своему первоклассному программному обеспечению.
Приложение iText pdfOCR, являющееся частью популярного пакета iText 7 PDF SDK, предлагает функцию оптического распознавания символов, позволяющую конвертировать печатный текст в отсканированных документах и изображениях в документ формата PDF/A-3u с поддержкой полнотекстового поиска (PDF, версия 1.7) и обеспечивающую более быструю и легкую работу с такими текстами. Отсутствие машиночитаемого текста в печатных или отсканированных документах не позволяет осуществлять поиск, индексирование или перевод таких документов. После распознавания текста можно извлечь данные из документа с помощью дополнения iText pdf2Data, безопасно отредактировать его содержимое с использованием iText pdfSweep или воссоздать многоязычные документы с помощью iText pdfCalligraph. Видоизменение данных с помощью генератора низкоуровневых кодов iText DITO® часто становится завершающим штрихом в работе с документом.
Дополнение iText pdfOCR работает на движке оптического распознавания символов Tesseract. Движок Tesseract поддерживает более 100 языков. Он был разработан компанией Hewlett-Packard в 1985 году, а в 2005 г. выпущен под лицензией Apache, как программное обеспечение с открытым исходным кодом. С 2006 года проект развивался при спонсировании компанией Google.
«Пандемия COVID-19 вынуждает компании ускорять процессы цифровой трансформации, и организациям приходится искать новые способы доступа к своим данным и управления ими. Это касается как уже существующих, так и новых данных. Являясь лидером в области цифровой документации, мы рады находиться на авансцене этой новой эры. Поэтому я с гордостью сообщаю о выпуске новейшего дополнения к нашему набору инструментов для работы с PDF-файлами, который отвечает вызовам современности. Благодаря возможностям оптического распознавания текста iText pdfOCR пользователи и предприятия смогут раскрыть весь потенциал своих данных», — сообщает Ёнсу Ким (Yeonsu Kim), генеральный директор компании iText Group NV.
«Сохраняя наши принципы работы с открытым исходным кодом, мы решили создать дополнение iText pdfOCR, работающее на движке оптического распознавания символов Tesseract с открытым исходным кодом. Таким образом мы хотим укрепить свою репутацию компании, работающей с открытым исходным кодом, ведь за это нас ценят миллионы пользователей и клиентов».
«С помощью этого нового дополнения к нашему набору инструментов для работы с PDF-файлами разработчики смогут извлекать из документов заблокированные данные, которые ранее были недоступны. Наш новый продукт расширяет возможности цифрового рабочего процесса. Он позволяет извлекать данные, хранящиеся в недрах отсканированных файлов, и использовать их для любых целей, которые могут возникнуть у операторов или конечных пользователей», — объясняет Тони Ван ден Зегель (Tony Van den Zegel), вице-президент отдела маркетинга и продукции компании iText Group NV и генеральный директор iText Software Belgium.
Приложения iText pdfOCR могут использоваться для самых разных целей: архивирование исторических документов, перевод юридических документов, автоматический ввод данных при обработке всевозможных физических заявлений или претензий, а также сортировка печатных или отсканированных документов, непригодных для редактирования. 9 июля 2020 года состоится презентация в прямом эфире, не пропустите! Более подробную информацию можно получить на вебстранице www.itextpdf.com/events
О компании iText
Компания iText является мировым лидером в области разработки инновационного программного обеспечения для работы с PDF-документами. Миллионы людей пользуются продуктами компании — как коммерческими, так и продуктами с открытым исходным кодом. Наше программное обеспечение применяется в различных компаниях из списка Fortune 500: от технологических, финансовых и туристических до медицинских, а также в небольших фирмах и государственных учреждениях. Штаб-квартира компании расположена в Бельгии. Представительства имеются в странах Азии (Сингапур и Южная Корея) и в США (Бостон).
www.itextpdf.com